De webcoördinator van een provincie belde me vorig jaar na een drukbezochte informatieavond. Er was iets misgegaan met de registratiepagina, maar hij wist niet precies wat. Wanneer viel het bezoek terug, welke pagina stopte bezoekers, had de campagne er iets mee te maken? Om die drie vragen te beantwoorden had hij drie aparte rapporten nodig. Tegen de tijd dat die klaar waren, was de bijeenkomst allang voorbij.
Die situatie is herkenbaar voor iedereen die analytics gebruikt maar geen analist is. Je weet wat je wilt weten. Je weet niet hoe je de tool daarvoor instelt.
De AI-interface lost dat op. Je stelt de vraag in gewone taal. De agent bepaalt zelf hoe hij tot een antwoord komt, haalt de juiste data op en geeft het terug als tekst, grafiek of tabel, rechtstreeks in de chat.
Je dashboardcontext is al ingeladen
Elke chat begint met de context van het dashboard dat je op dat moment bekijkt: de geselecteerde periode, de actieve metric en de filters die je hebt ingesteld. Die informatie gaat mee naar de agent, zodat je niet hoeft uit te leggen wat je aan het bekijken bent.
Daardoor werkt zelfs een korte vraag. Vraag “Hoe gaat het met de website?” en de agent weet al dat je naar de bezoekers van de afgelopen 28 dagen kijkt, haalt de trend op en vat samen wat eruit springt.
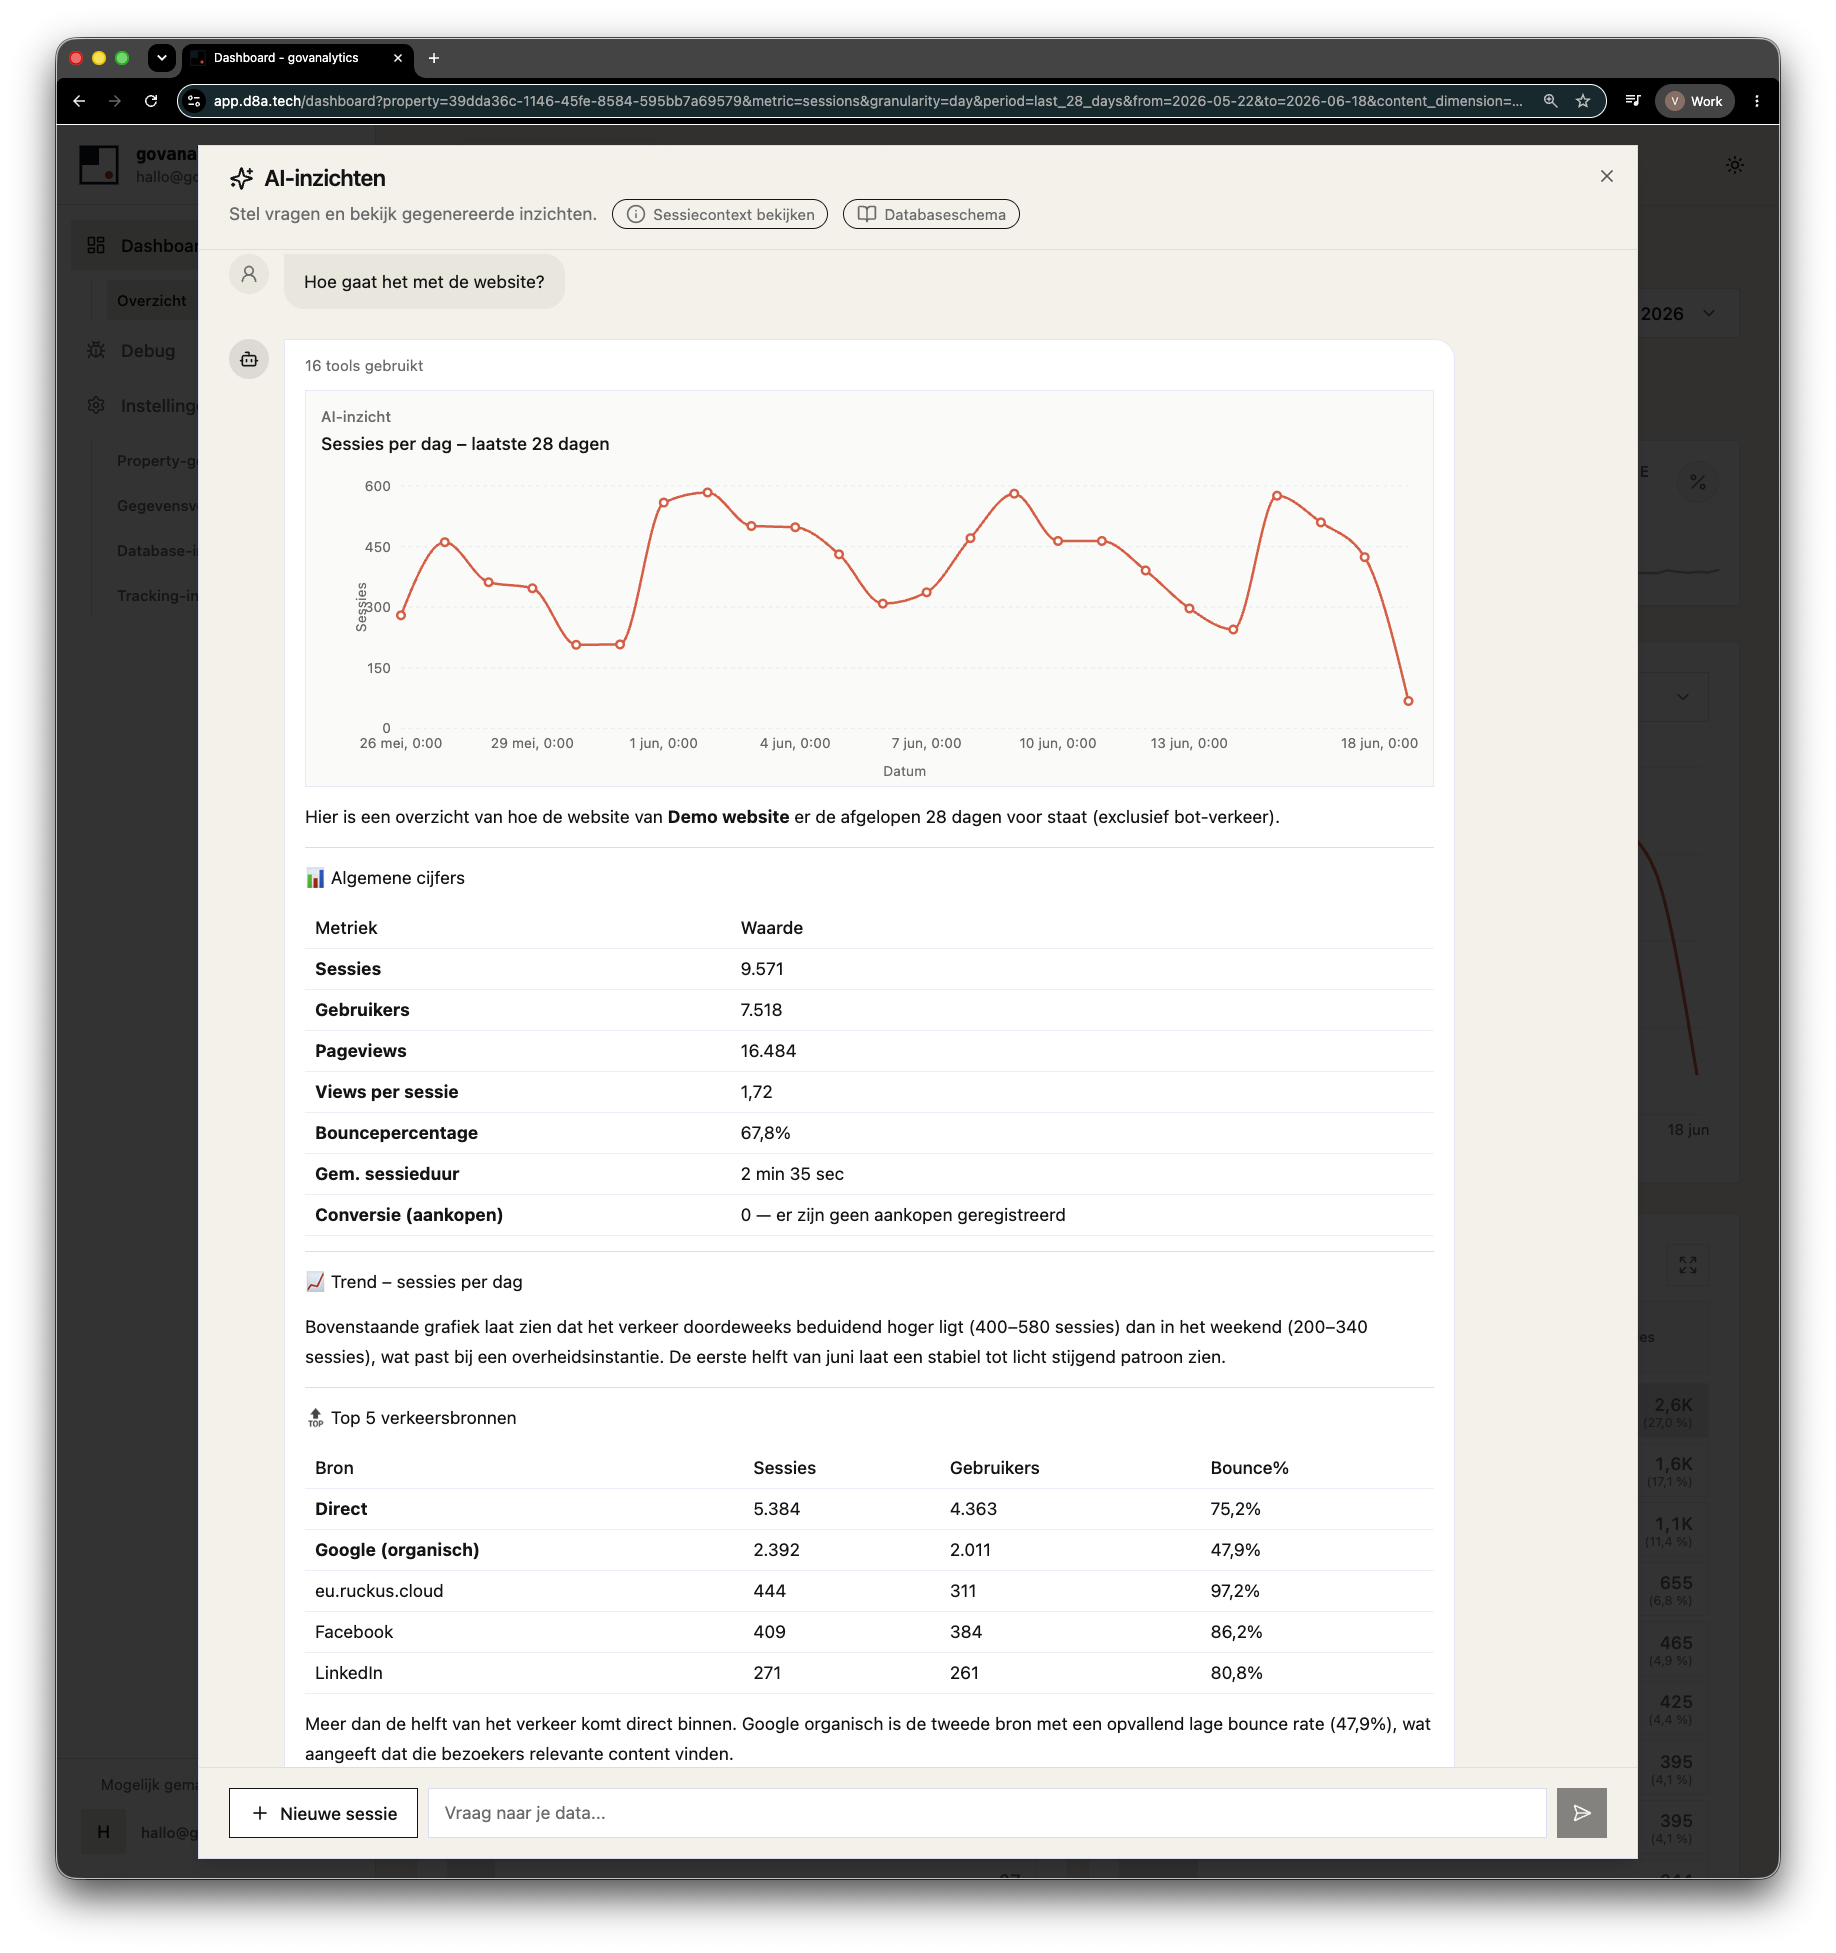
De context is geen verborgen instelling. Je kunt op elk moment precies inzien wat er naar de agent is gestuurd. Wijzig je het dashboard, dan pakt een nieuwe sessie de actuele stand op met één klik.
Twee wegen naar het antwoord
De agent heeft twee manieren om bij je data te komen, afhankelijk van wat de vraag vraagt.
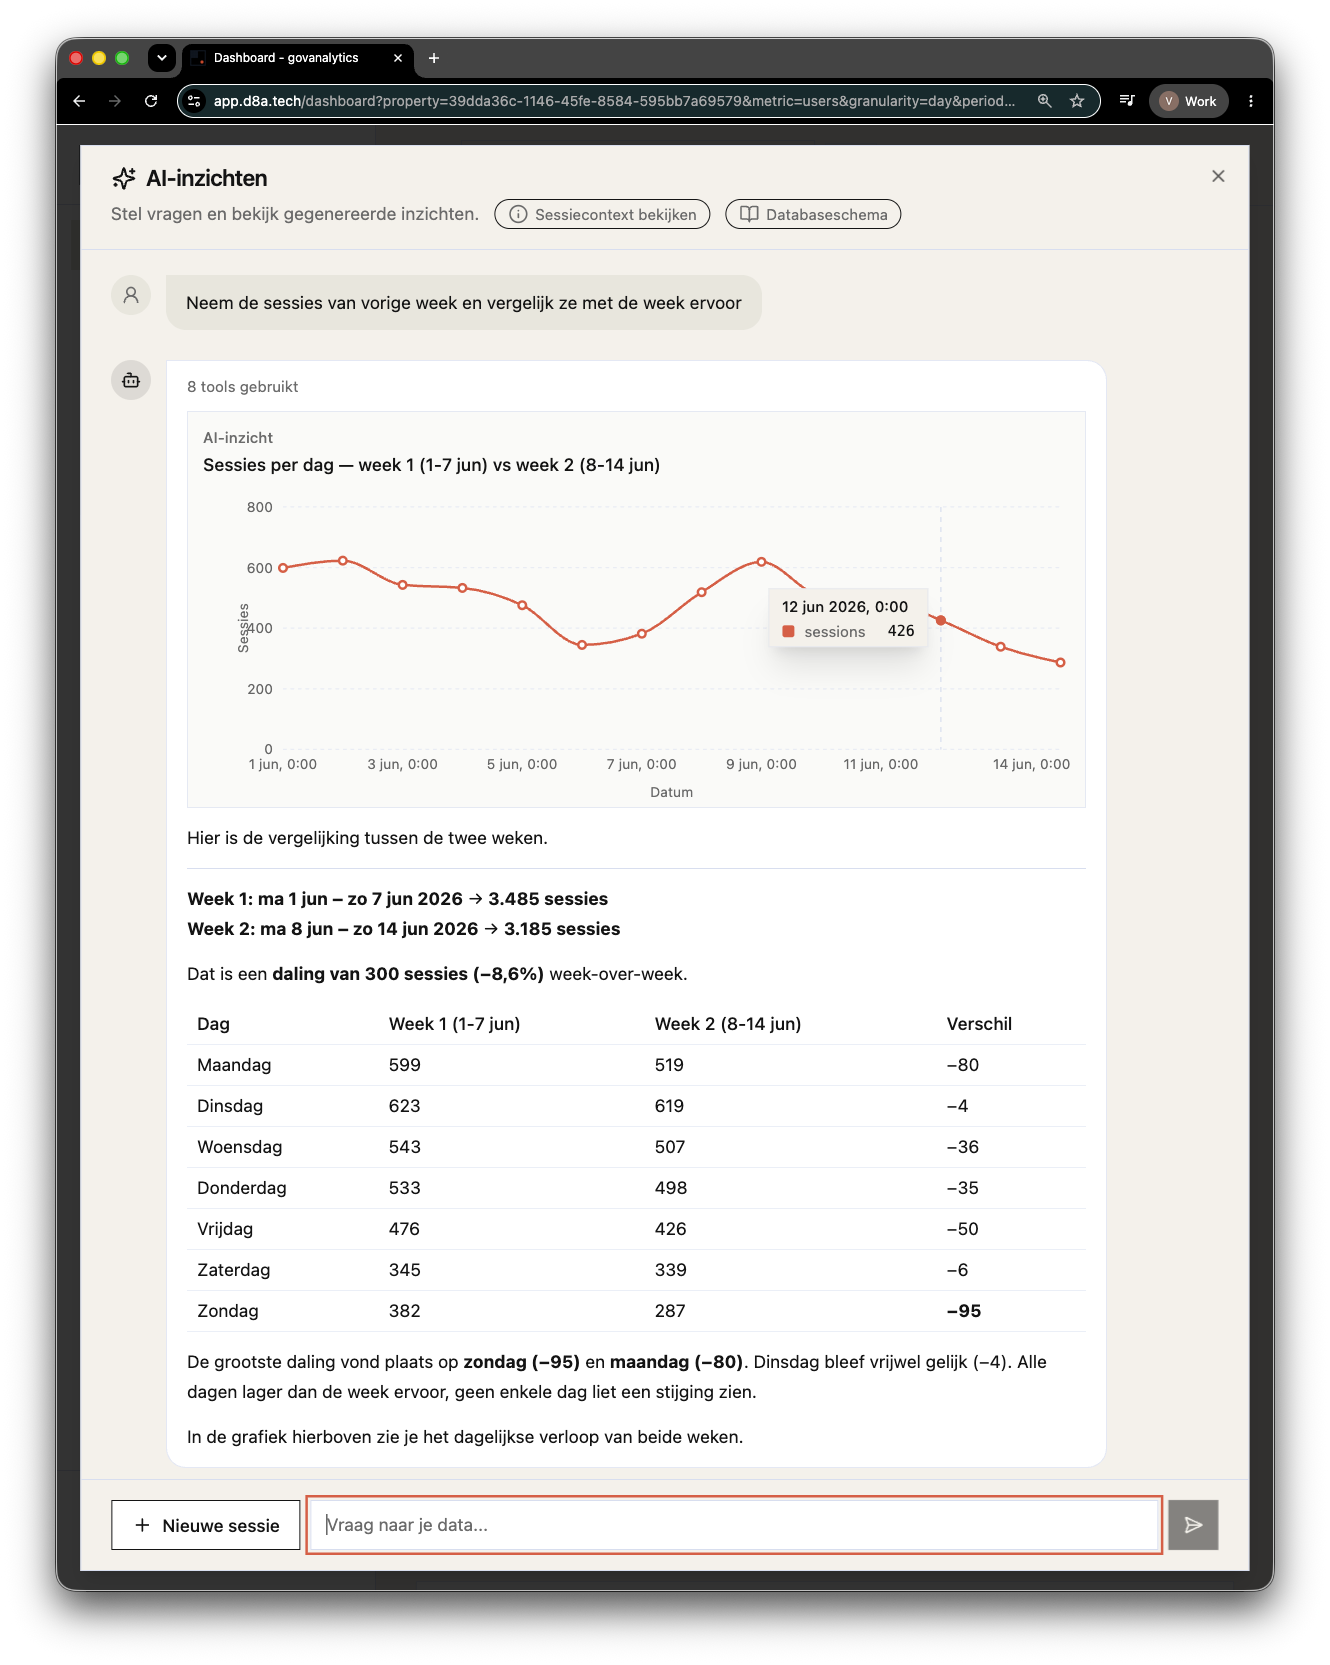
Via de rapportage-API. Dezelfde API die de dashboards voedt. Voor vragen over trends, vergelijkingen en uitsplitsingen roept de agent die aan zoals elke andere client dat doet. “Neem de sessies van vorige week en vergelijk ze met de week ervoor” levert één grafiek en een dag-voor-dag-tabel op.
Via directe read-only databasevragen. Voor vragen waarvoor geen kant-en-klaar rapport bestaat, schrijft de agent zelf SQL tegen dezelfde tabellen die je BI-tools ook mogen gebruiken. Denk aan een eigen funnel uit één event-parameter, of een vergelijking die twee rapportperioden en een segment combineert. De agent bekijkt het schema, schrijft zijn eigen alleen-lezen query en rapporteert het resultaat.
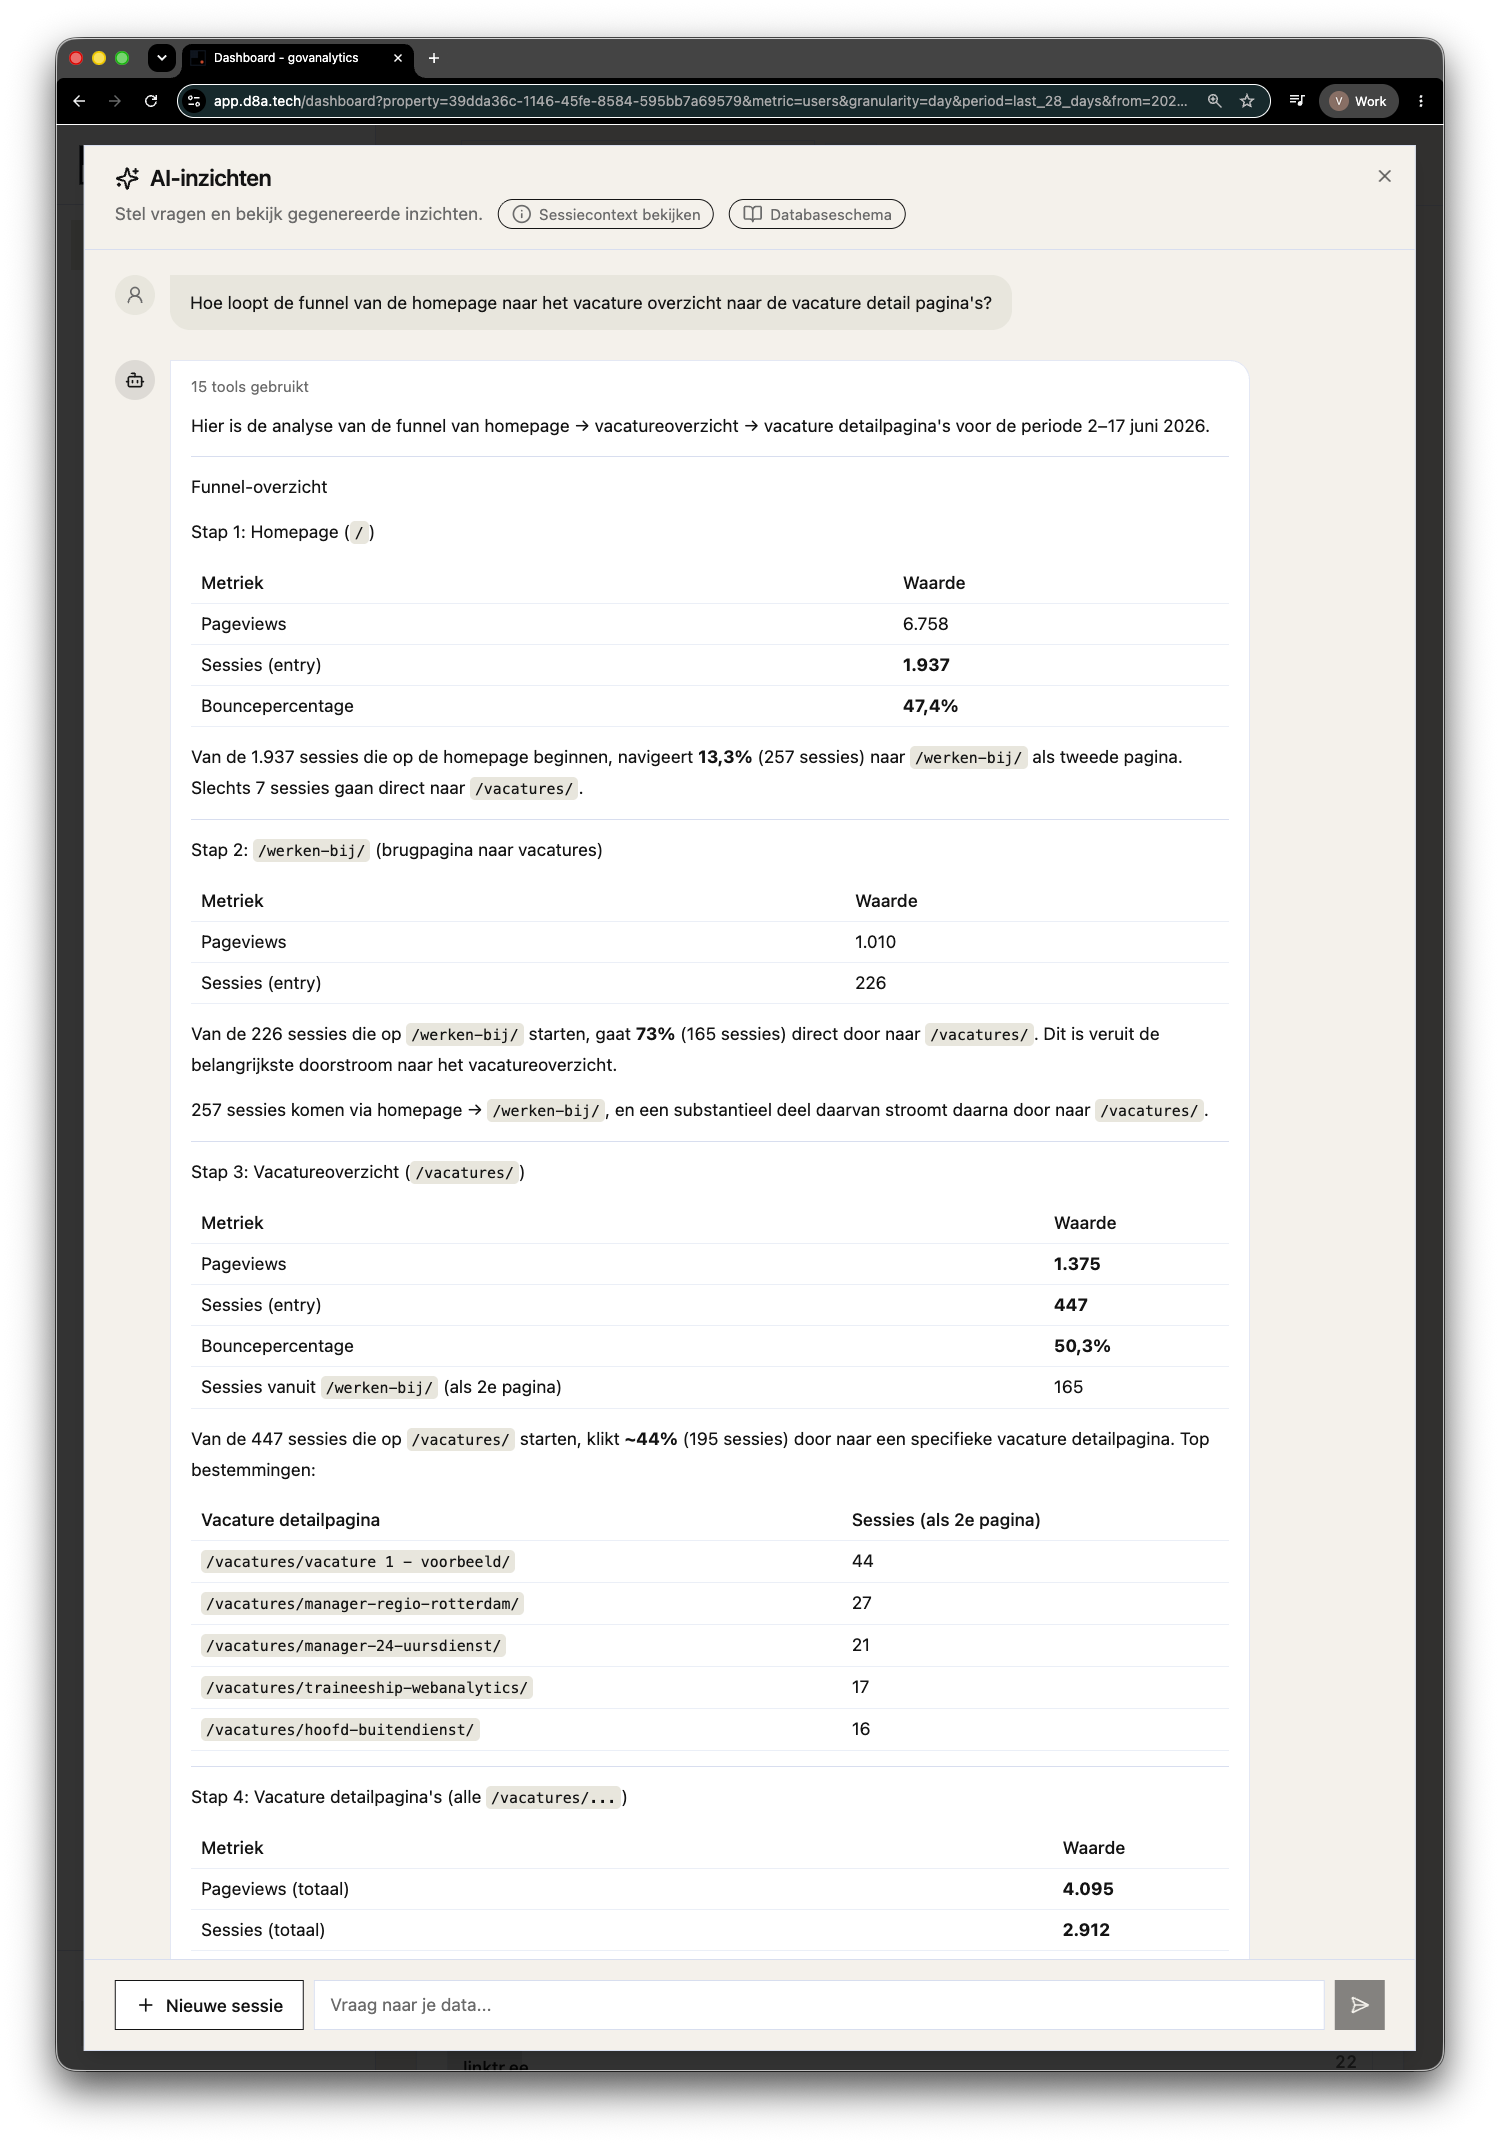
Dit werkt door een architectuurkeuze die lang vóór de agent is gemaakt: het datawarehouse-schema is plat, gedocumenteerd en ontworpen om door mensen én BI-tools bevraagd te worden. Wat makkelijk te bevragen is voor een analist, is ook makkelijk te bevragen voor een taalmodel. Schone, gedocumenteerde data is wat “AI-ready” werkelijk betekent.
Gebouwd binnen de [gov]-standaard
Een taalmodel rechtstreeks toegang geven tot je analyticsdata is het punt waarop de meeste organisaties terecht kritisch worden. De AI-interface is daarom van de eerste regel af binnen de [gov]-standaard gebouwd, niet erlangs.
Eén property per sessie. Elke sessie heeft toegang tot precies één property. Er is geen weg naar andere tenants of andere properties. Die scheiding zit niet in een prompt die het model vriendelijk vraagt zich te gedragen: ze zit onder het model, in de toegangslaag.
Read-only, by construction. De databasetoegang van de agent is alleen-lezen. Hij kan je data bevragen, maar niet wijzigen, verwijderen of ergens naartoe exporteren.
Inzichtelijke context. Wat de agent ontvangt, staat in de context-weergave van de sessie. Niet verstopt in een prompt die je niet kunt inzien.
De grenzen liggen in de architectuur, niet in het contract. De orkestratie, de datatoegang en de isolatie leven in de kern van het platform, niet in het taalmodel. Het model is een verwisselbaar onderdeel. De read-only-toegang en de scheiding per property gelden ongeacht welk model je kiest.
EU-taalmodellen als standaard
Standaard gebruikt de agent EU-gebaseerde taalmodellen. Het standaardmodel is volledig open source en draait op EU-infrastructuur. Je vragen, je dashboardcontext en de queryresultaten die de agent leest, verlaten de EU niet.
Als je voor Govanalytics koos omdat je wilt weten waar je data staat, zou een AI-functie die je analyticsdata stilletjes naar een Amerikaans inference-eindpunt stuurt, die keuze ongedaan maken. Zo werkt het hier niet.
Je eigen model als je dat wilt
De intelligentie van de agent zit niet in één specifiek model. De orkestratie, de datatoegang en de veiligheidsgrenzen zitten in de kern van Govanalytics. De LLM-API is een verwisselbaar onderdeel dat de kern beheert.
Dat heeft een praktische consequentie: organisaties met een bestaande overeenkomst met een modelleverancier, of met eigen inference, kunnen de AI-interface daarmee verbinden.
Elk model dat voldoende scoort op gangbare benchmarks werkt goed met onze opzet. Dat betekent dat je kosten, snelheid en leverancierskeuze vrij tegen elkaar kunt afwegen zonder de functie zelf te verliezen.
Begin met een vraag die je half al kent
Open een dashboard, start een chat en stel de vraag die je normaal in een rapportverzoek zou omzetten.
Begin met iets waarvan je het antwoord al half weet. Zien hoe de agent dezelfde cijfers ophaalt die je zelf ook zou ophalen, alleen sneller, is de snelste manier om vertrouwen op te bouwen in de antwoorden die je niet had voorspeld.
Veelgestelde vragen
-
Nee. De databasetoegang van de agent is strikt alleen-lezen. De agent kan je data bevragen, maar niet wijzigen, verwijderen of ergens naartoe sturen. Dat is geen instelling, maar een architectuurkeuze die onder het model zit.
-
Het standaardmodel is volledig open source en draait op EU-infrastructuur. Je data verlaat de EU niet bij gebruik van het standaardmodel. Je kunt ook een eigen model koppelen als je organisatie een eigen afspraak of eigen inference heeft.
-
Nee. Elke sessie heeft toegang tot precies één property. Die scheiding zit in de toegangslaag, niet in een promptinstructie aan het model.
-
Ja. De sessiecontext laat precies zien welke informatie naar de agent is verstuurd: de periode, de actieve metric en de actieve filters. Er is geen verborgen systeemprompt die je niet kunt inzien.
-
Ja. Als een vraag niet via de rapportage-API te beantwoorden is, schrijft de agent zelf een read-only SQL-query tegen het datawarehouse. Je hoeft geen SQL te kennen; de agent bepaalt zelf hoe hij de vraag beantwoordt.
-
Nee. De interface is precies bedoeld voor situaties waarbij je weet wat je wilt weten, maar niet hoe je een rapport daarvoor instelt. De agent neemt de vertaalslag van vraag naar data voor zijn rekening.